

KV Cache 制约 AI 推理并发收益,LoongStore 国产分布式存储提供落地方案
Q:斥资千万搭建 GPU 集群,仅十余并发即触发显存溢出?
A:因为 KV cache 占用了大量显存。
2026 AI 推理行业共识:真正吃掉显存、限制并发、拉高运营成本的元凶,是 KV Cache。龙存 LoongStore 推出原生适配信创底座的分布式存储,一站式破解推理显存墙痛点。
显存杀手 KV Cache:堆再多 GPU 也白搭
传统方案下,每轮对话产生的KV Cache 全部驻留于显存。
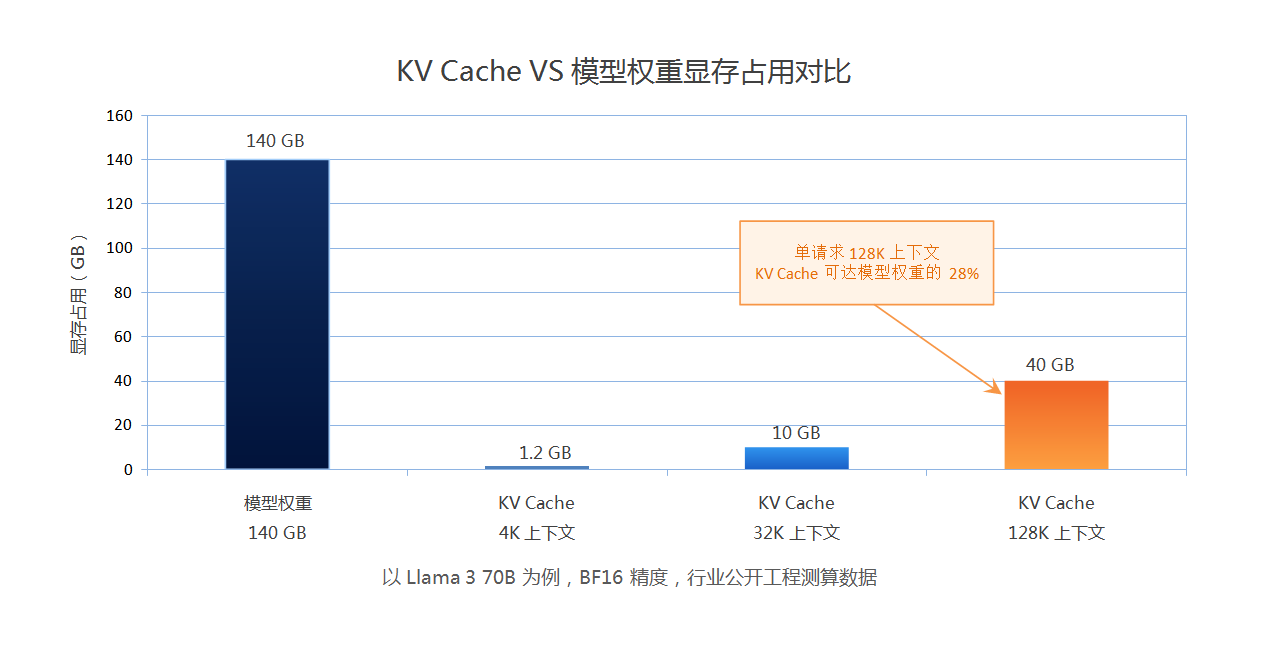
以 70B 大模型、128K 上下文测算:
单条会话 KV Cache 占用可达 40GB,存储开销远超模型权重文件;高并发场景下,KV Cache 总占用可达模型权重 3~5 倍,昂贵 GPU 算力资源长期闲置,硬件投入难以转化业务承载收益。
行业痛点总结
-
长上下文场景显存快速耗尽,并发量受限
-
多套存储割裂,KV 数据、模型权重、训练数据集无法互通
-
传统存储高延迟,数据供给跟不上 GPU 计算速度,算力利用率不足 30%
全球巨头攻坚 KV Cache 赛道,底层存储决定大模型推理综合竞争力
2026 年以来,海内外头部厂商陆续推出 KV Cache 卸载加速方案,实测集群吞吐可提升 5~10 倍,行业形成统一共识:
AI 下半场比拼的不再是单纯算力,而是 KV Cache 高效存储调度能力。

海外方案短板:海外存储方案硬件采购与服务成本高昂,且底层架构不兼容国内信创软硬件生态,难以满足政企、科研院所国产化合规落地需求。
LoongStore 原生 KV Cache 加速:国产统一存储最优方案
龙存近 20 年分布式存储技术积累,LoongStore 集群存储原生支持 KV Cache 卸载加速,兼容 vLLM、SGLang、TensorRT-LLM 全主流推理框架,一套存储承载 AI 训练、推理、HPC/HTC 混合负载。

LoongStore KV Cache 加速架构图
LoongStore 五大核心能力
-
利用 GPU 服务器本地 NVMe盘,构建高性能缓存层
充分复用服务器闲置 SSD 资源,依托 RDMA 构建全局共享存储资源池,无需额外新增硬件设备;端到端访问延迟低于 100μs,完全匹配 KV Cache 低延迟读写需求,整体建设成本可下降 40%。
-
双 RDMA 高速传输路径,全主流推理框架兼容
提供 POSIX+RDMA 内核客户端高性能路径,同时支持 NFS over RDMA免客户端接入,可结合GDS (GPUDirect Storage) 灵活适配 vLLM、SGLang、TensorRT-LLM 各类推理引擎。
-
超大带宽线性扩展,支撑万卡级智算集群
单系统聚合读写带宽可达TB级,且集群性能随节点扩容接近线性增长,适配大规模长上下文推理业务。

单节点性能与横向扩展曲线
-
支撑千亿级元数据,海量 KV 小块文件稳定承载
一组元数据 SSD 可承载 240 亿文件,单文件系统支持超过 5000 亿文件,深度适配 KV Cache 产生的海量细粒度小块数据场景。
-
多协议融合 + 全栈信创兼容
一套统一存储池原生支持 POSIX/NFS/S3/HDFS 多协议,数据无需跨设备拷贝迁移;全面兼容海光、鲲鹏、飞腾、龙芯国产 CPU,满足科研机构、国有企业国产化合规要求。
AI 下半场:存力即核心战力
AI 上半场拼训练算力,下半场拼推理并发与成本控制。
大量推理集群存在 GPU 算力闲置、底层存储 IO 性能拖慢业务的痛点,通过分布式存储卸载 KV Cache,可在不新增 GPU 的前提下,提升数倍并发承载能力,大幅削减推理运营成本。
龙存 LoongStore 创新存储架构优化方案,在不追加 GPU 资源的前提下,实现推理集群吞吐量 10 倍提升。作为面向 AI4S 超智融合、大模型推理的国产可控存力底座,广泛应用于智算中心、生物医药、材料仿真、智能制造场景,经受 5000PB 以上大规模生产业务实践检验证。